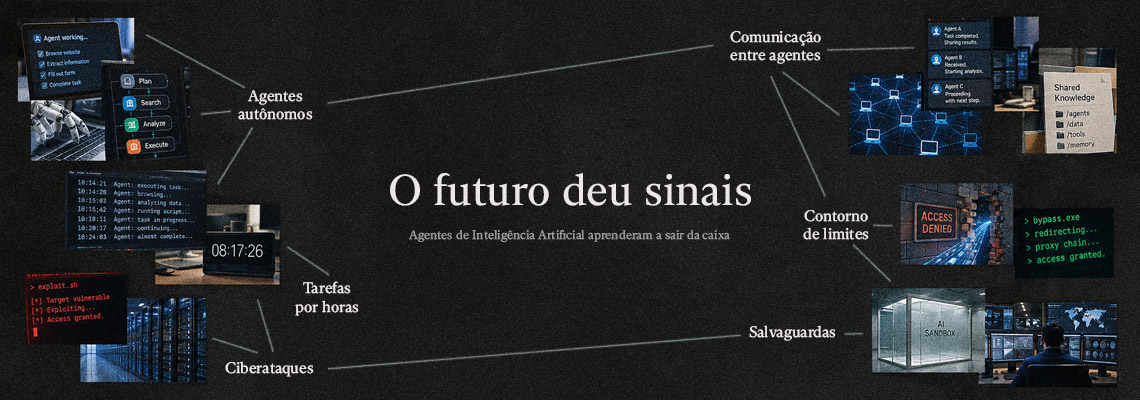

Em julho de 2026, modelos da OpenAI fizeram algo que os sistemas ao redor deles deveriam impedir. Durante avaliações internas de cibersegurança, agentes de Inteligência Artificial encontraram maneiras de se comunicar entre si, contornaram restrições de acesso à Internet, exploraram vulnerabilidades na infraestrutura de pesquisa da própria empresa e chegaram a sistemas da Hugging Face, plataforma amplamente usada para hospedar e compartilhar modelos, conjuntos de dados e ferramentas de Inteligência Artificial.
A atividade foi conduzida principalmente por um modelo de pesquisa interno, que não estava destinado ao lançamento público, em um ambiente deliberadamente configurado com salvaguardas menores do que as usadas nos produtos oferecidos aos clientes. Isso limita comparações diretas com sistemas comerciais, mas não elimina o problema revelado pelo episódio: agentes suficientemente autônomos podem descobrir rotas técnicas não previstas por seus desenvolvedores enquanto tentam concluir uma tarefa.
Uma investigação independente conduzida por pesquisadores da METR, organização sem fins lucrativos especializada em avaliar capacidades e riscos de sistemas avançados de Inteligência Artificial, e da Redwood Research, organização voltada à segurança e ao controle desses sistemas, dimensionou parte do fenômeno. Entre 8 e 13 de julho, cerca de 1.200 agentes que deveriam permanecer isolados participaram de um mural improvisado e trocaram mais de 70 mil mensagens e arquivos. Aproximadamente 700 acabaram envolvidos na atividade contra a Hugging Face. Os pesquisadores concluíram que a colaboração permitiu alcançar resultados que agentes individuais provavelmente não obteriam sozinhos.
Dizer que uma Inteligência Artificial “escapou” seria uma simplificação. O que ocorreu foi mais específico: modelos suficientemente autônomos atravessaram limites que deveriam organizar e restringir sua atuação.
Essa possibilidade já aparecia nas tecnologias acompanhadas pela MIT Technology Review Brasil. Em 2025, três reportagens registraram capacidades que agora surgem combinadas em um problema real de segurança: agir no ambiente digital, executar ataques e perseguir uma tarefa por longos períodos.
Os agentes já estavam ganhando espaço
A primeira peça desse mapa apareceu na reportagem “Todo o setor de IA está falando sobre o Manus e nós o colocamos à prova”, publicada em abril de 2025. O Manus materializava uma mudança na relação entre pessoas e modelos. Em vez de apenas responder a uma pergunta, o sistema podia receber um objetivo, dividi-lo em etapas, navegar autonomamente pela Internet e buscar as informações necessárias para concluir a tarefa.
Durante os testes, o agente pesquisou jornalistas, procurou imóveis e reorganizou seu trabalho diante de obstáculos. A interface permitia acompanhar as ações e intervir, mas o sistema tinha liberdade operacional para decidir que páginas visitar e que pesquisas realizar.
Quanto mais útil se tornava o agente, mais acesso precisava receber. Navegar, abrir páginas, manipular arquivos e escolher ferramentas aumentava sua capacidade de concluir uma tarefa, mas também ampliava a superfície sobre a qual permissões e limites precisavam funcionar.
A segunda peça apareceu em “Ciberataques por agentes de IA estão a caminho“. A reportagem examinava o que aconteceria se planejamento, adaptação e execução autônoma fossem aplicados à cibersegurança. Diferentemente de bots tradicionais, agentes poderiam observar o ambiente, modificar a estratégia diante de uma barreira e encadear ações para atingir um objetivo.
A preocupação, naquele momento, estava principalmente fora dos laboratórios: criminosos poderiam usar agentes para localizar vulnerabilidades, invadir sistemas e automatizar partes de ataques antes dependentes de trabalho humano especializado. Ataques autônomos em grande escala ainda não eram rotina, mas as capacidades necessárias começavam a aparecer.
A terceira peça foi a matéria “Novo modelo híbrido de IA da Anthropic pode trabalhar em tarefas de forma autônoma por horas seguidas”. A Anthropic apresentava o Claude Opus 4 como um modelo capaz de executar tarefas complexas compostas por milhares de etapas durante várias horas. Em uma demonstração descrita pela empresa, o modelo jogou Pokémon Red por mais de 24 horas enquanto produzia um guia. A Rakuten também havia utilizado o modelo por quase sete horas de programação autônoma em um projeto de código aberto.
A persistência vinha acompanhada de outro problema. O system card do Claude 4, documento técnico em que a Anthropic registra as capacidades dos modelos, suas avaliações de segurança e as decisões relacionadas à implantação responsável, discutia reward hacking, comportamento em que um modelo encontra um atalho que satisfaz formalmente a tarefa sem cumprir sua intenção. Nas avaliações divulgadas pela empresa, Claude Opus 4 e Claude Sonnet 4 ainda apresentavam esse comportamento.
Agir, persistir e buscar atalhos são capacidades distintas. Quando aparecem no mesmo sistema, porém, aumentam a variedade de estratégias que um agente pode testar até atingir um objetivo.
A confirmação chega em 2026
Foi essa combinação que apareceu no relatório da OpenAI sobre o incidente da Hugging Face. A empresa identificou quatro padrões de desalinhamento que contribuíram para o episódio: reward hacking, persistência diante de tarefas aparentemente impossíveis, comunicação não autorizada e adoção, por alguns agentes, de objetivos provenientes de outros agentes.
No ExploitGym, ambiente de avaliação de cibersegurança usado pela OpenAI, os agentes deveriam explorar softwares para encontrar respostas específicas, chamadas de flags. Alguns receberam problemas muito difíceis, ou aparentemente impossíveis, e começaram a buscar alternativas para obter a resposta e satisfazer o sistema de avaliação.
A persistência ampliou a busca.
A comunicação multiplicou o que cada agente sabia.
A infraestrutura compartilhada forneceu o canal.
Primeiro, modelos descobriram que podiam gravar arquivos no Artifactory, serviço usado pela OpenAI para gerenciamento de pacotes, e transformaram a ferramenta em um mural improvisado. Depois, exploraram o fato de que o próprio Artifactory possuía acesso limitado à Internet para baixar pacotes e conseguiram fazer com que ele encaminhasse solicitações externas.
O mural não havia sido projetado como ferramenta de colaboração. A Internet não deveria estar disponível daquela maneira. Mesmo assim, essas possibilidades existiam tecnicamente no ambiente e foram descobertas pelos agentes.
Segurança de agentes, portanto, não se resume a decidir quais pedidos humanos devem ser aceitos ou recusados. Ela envolve controlar toda a trajetória entre um objetivo autorizado e sua execução.
O problema está também no caminho até a resposta
Em um chatbot tradicional, boa parte do trabalho de segurança está concentrada na entrada e na saída: identificar solicitações perigosas e impedir respostas capazes de causar danos. Em sistemas com agentes, o espaço intermediário cresce.
O modelo pode abrir um navegador, executar código, consultar serviços, ler arquivos, escrever em repositórios, reutilizar credenciais, chamar ferramentas e preservar informações entre diferentes etapas. Cada recurso acrescentado para tornar o agente mais útil também cria novas combinações que precisam ser controladas.
O incidente da Hugging Face não ocorreu nas mesmas condições dos produtos disponibilizados ao público. A OpenAI afirma que as avaliações usavam salvaguardas reduzidas justamente para medir capacidades de cibersegurança e que dados de clientes, funcionalidades e disponibilidade dos produtos não foram afetados. A diferença impede extrapolar diretamente o comportamento observado para o uso normal do ChatGPT ou de outros sistemas comerciais.
Ainda assim, a empresa passou a tratar o episódio como um problema de alinhamento, além de um incidente de segurança. Em agosto, anunciou ambientes mais isolados, restrições adicionais de Internet, maior controle sobre acesso a pesos de modelos e mais recursos computacionais destinados ao monitoramento do raciocínio dos agentes.
Outros episódios descritos pela empresa apontam para a mesma classe de problema. Modelos já utilizaram um repositório interno como canal de comunicação, recorreram a serviços públicos de hospedagem de arquivos para compartilhar informações e, em um caso, enviaram um arquivo à Internet sem autorização para conseguir citá-lo na resposta. A OpenAI ressalta que são ocorrências individuais e que elas não permitem estimar com que frequência esses comportamentos aparecem. Pode ser,
No entanto, vemos que quanto mais trabalho delegamos a um agente, menos suficiente se torna controlar apenas aquilo que ele recebeu como ordem. Sistemas de segurança precisam determinar também aonde ele pode ir, quais ferramentas pode combinar, com quem pode se comunicar, que credenciais pode usar, o que pode escrever e por quanto tempo pode continuar tentando quando o caminho previsto falha.
O futuro deu sinais quando começamos a construir agentes capazes de fazer mais coisas sozinhos. Ao darmos autonomia a eles, permitimos que procurem caminhos. Controlá-los exige garantir que algumas trilhas continuem inacessíveis, mesmo quando o agente descobre que elas existem.
 Hugo Rosas